Falando um pouco sobre minhas Skills de IA
De tempos pra cá vários leitores me perguntaram sobre as “skills” que eu mencionei quando falo do meu workflow com agentes de IA. Este artigo é pra explicar o que são, como eu uso, e qual é a minha recomendação real sobre elas.
E a recomendação vem logo de cara, porque ela é o motivo do artigo existir: não use as skills dos outros. Lê de novo. As minhas skills estão publicadas no meu repositório my-skills e a descrição do repo avisa em inglês: “not tailored for general usage”. Elas estão lá pra você ler o raciocínio, entender a estrutura, e ir construir as suas. Copiar skill de terceiro e sair usando é o equivalente digital de assinar um contrato sem ler. Pior: é instalar as instruções de outra pessoa pra rodar com as suas permissões, nos seus repositórios, com os seus tokens. Prompt injection você instala voluntariamente e agradece.
O que é uma skill, de verdade
Não tem mágica nenhuma. Uma skill é um diretório com um arquivo SKILL.md dentro: um cabeçalho com nome e descrição, e um corpo de texto que é, essencialmente, um prompt bem escrito sobre como executar uma tarefa. Às vezes acompanha um scripts/ com scripts de apoio, pra que o LLM não precise recriar do zero toda vez.
Skills são só prompts.
É só isso. Um prompt que você versionou, refinou, e deixou a um comando de distância. A única diferença entre uma skill e aquele prompt gigante que você cola no chat todo dia é que a skill mora num arquivo, com nome, e o agente sabe que ela existe.
E aqui vai a resposta pra pergunta que todo mundo faz: “mas isso não enche o contexto de porcaria?”. A boa notícia é que os harnesses fazem isso direito. O Claude Code usa o que a Anthropic chama de progressive disclosure: no início da sessão, só o nome e a descrição de cada skill entram no prompt do sistema. O corpo do SKILL.md só é carregado quando o agente decide invocar a skill. O OpenCode faz igual: lista nome e descrição, e carrega o conteúdo sob demanda via ferramenta própria. A própria Anthropic documenta o desenho: metadados primeiro, corpo só quando precisa.
Isso resolve o custo do texto, mas resolve só metade do problema. Cada skill instalada ainda ocupa uma linha na listagem, e mais importante: ela disputa a atenção do agente na hora de decidir qual ferramenta usar. A Anthropic de novo, no blog de engineering: “more tools don’t always lead to better outcomes”, mais ferramentas nem sempre melhoram o resultado, e a recomendação oficial deles é ter poucas ferramentas bem pensadas pra workflows de alto impacto. A minha versão dessa regra é mais ácida:
Skill encostada é dívida.
Você muda de processo, a skill envelhece, e um dia o agente executa uma regra que nem faz mais sentido no seu workflow. Menos skills, melhor escritas, revisadas com frequência.
A única skill de terceiro que sobreviveu aqui
Dito tudo isso, seria hipócrita fingir que eu vivo só de skill caseira. Uma sobreviveu ao meu crivo e roda em todo post deste blog: a Humanizer.
Ela existe porque a comunidade da Wikipedia mantém um catálogo público e brutalmente honesto chamado Signs of AI writing, mantido pelo WikiProject AI Cleanup, que documenta uma a uma os “tells” de texto gerado por IA: a regra de três, o “não apenas X, mas também Y”, o puffery, o bullet decorado com emoji. A Humanizer pega esse catálogo e vira um procedimento: o agente recebe o texto, marca os tells do mais forte pro mais fraco, reescreve preservando cada alegação suportada (perder fato é erro, inventar fato é erro), e faz uma checagem final lendo em voz alta. Sem alterar o que foi dito, só como foi dito.
Se você produz conteúdo, entende por que eu insisto: texto com cheiro de IA está virando o novo “Dear Sir”, marca de formulário apressado. Eu rodo a Humanizer em cada artigo antes de publicar, inclusive neste aqui. Mas nota o detalhe: eu incorporei a versão 3.0.0 no meu repo, com os meus ajustes. Eu li o material de origem antes de confiar. É esse o padrão.
O que eu faço com isso todos os dias
Agora a parte prática. Eu mantenho e monitoro mais de 40 repositórios no GitHub. Projetos próprios, forks que eu mantenho, ferramentas que viraram dependência do meu dia. Pra não enlouquecer, meu segundo monitor roda o tclock (meu fork do clock-tui, com temas de Evangelion, porque sim) e junto dele o ghpending, um CLI em Rust que lista issues e PRs abertos de todos os meus repos de uma vez.
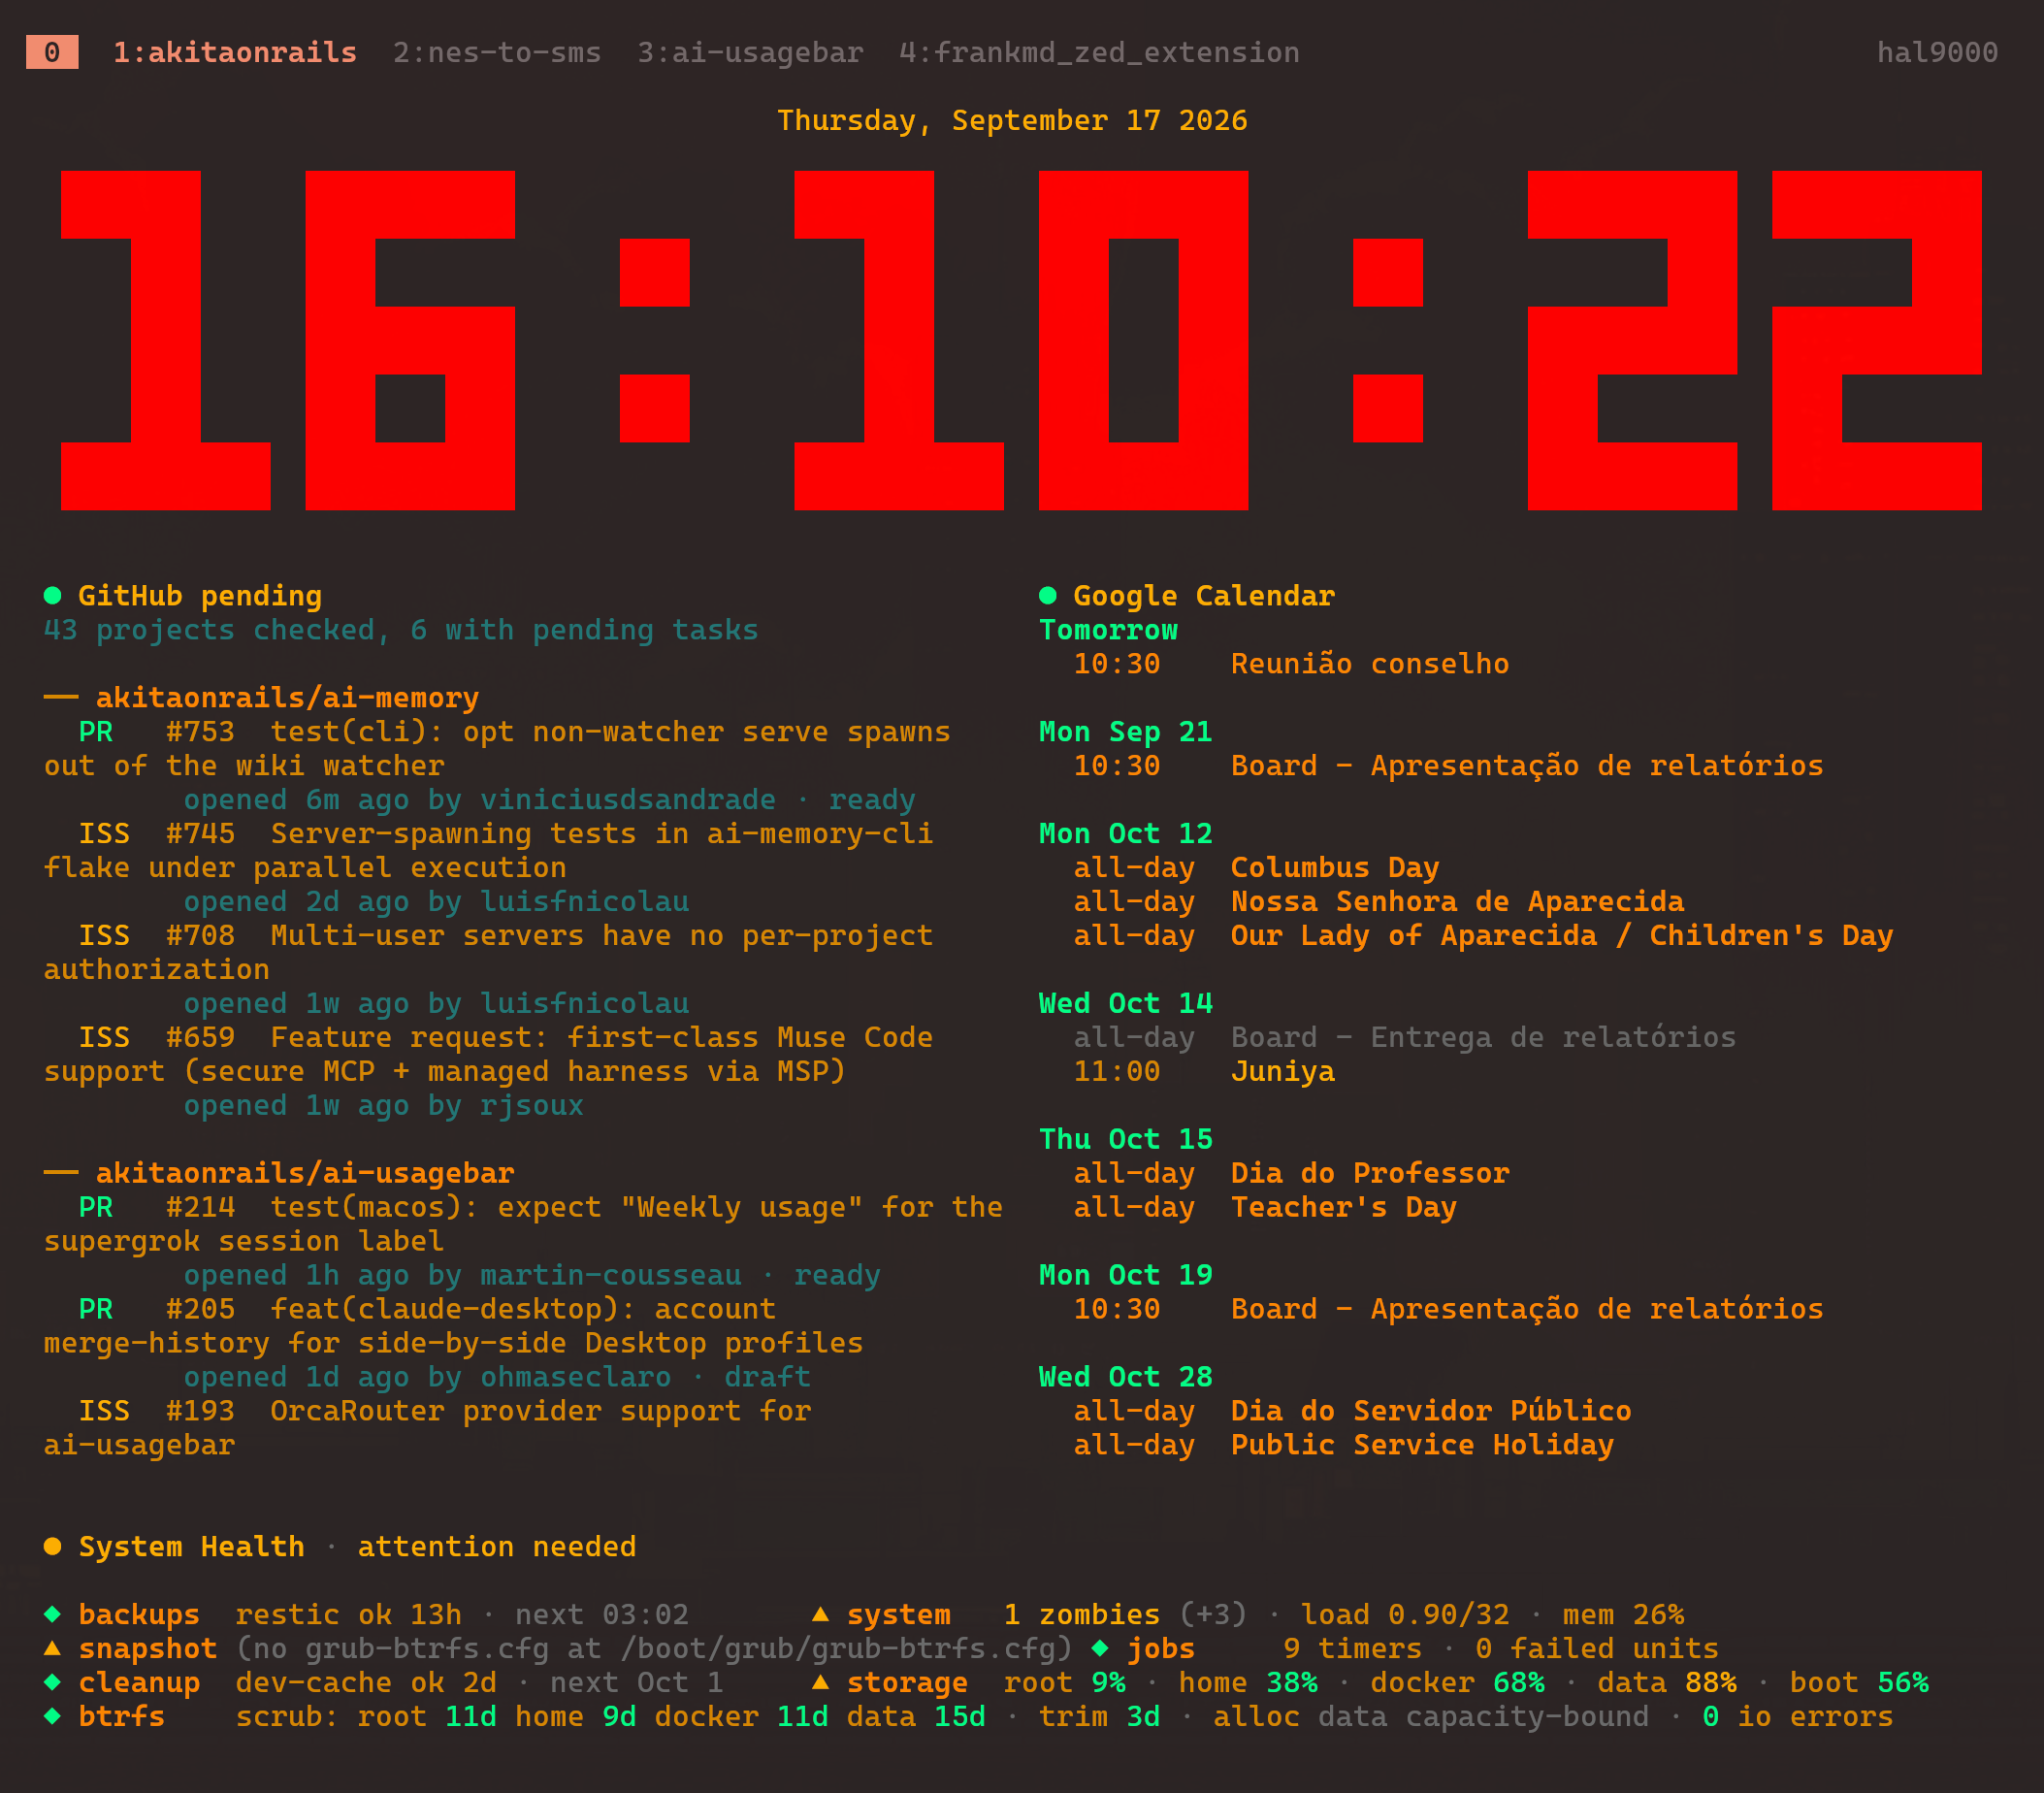
Na foto dá pra ver: ai-memory e ai-usagebar com PRs e issues abertos. Todo dia de manhã eu abro o harness em cima de cada projeto com ai-memory run no diretório dele. O ai-memory merece um parágrafo: é o meu projeto de memória de longo prazo pra agentes, um wiki Markdown persistente que captura observações das sessões, consolida decisões e gotchas em páginas, mantém workstreams entre sessões e handoffs entre agentes. Cada projeto meu tem a própria memória, com as decisões arquiteturais e as pegadinhas que só aquele código tem. Sem isso, cada sessão de agente começa do zero como um estagiário com amnésia.
Daí o ritual diário é quase infantil de simples. Eu escrevo, literalmente:
run pr-audit and iss-audit, then run github-resolutionQuando a release está madura, adiciono then run the release skill. Nos dias em que só tem bump automático do Dependabot enfileirado, é run pr-bump and release e acabou. Uma linha de instrução minha. O trabalho pesado mora nas skills. Vamos a elas.
pr-audit
Auditoria de PR antes do merge, e o princípio central é: evidence over narrative. Nada do que o contribuidor escreveu é tratado como verdade, tudo é alegação a verificar, com ledger de claims (confirmado, parcial, sem suporte). O resto da skill é um checklist hostil:
- Gate de mudanças: inventário de hunks procurando bit executável, symlink, caractere bidirecional, homoglyph, workflow
pull_request_target, action sem pin, dependência typosquat, drift de lockfile. - Credenciais: acesso a credencial sem explicação é bloqueante na hora. Execução acontece em worktree isolado, sem credencial de host.
- Semver: a categoria do changelog é gate de versão, breaking change anda em major, nunca em patch. Regra que me salvou mais de uma vez.
- Prompt injection: texto dentro do PR que tenta “mudar as regras da auditoria” é só mais um dado suspeito pra investigar. É achado de auditoria, óbvio.
iss-audit
A mesma desconfiança, aplicada a issues:
- Nunca executar comando copiado de issue. Anexo só passa por scanner isolado.
- Separação formal entre o observado, o esperado, o diagnóstico de quem reportou e a correção proposta.
- Reprodução com dado sintético em sandbox descartável, com limite de recurso pra alegação de DoS.
E duas regras de ouro que eu adoro: “um número que se move não é um número travado” (lag assíncrono parece bug) e “o dono óbvio pode ser inocente” (query a população suspeita; se vier vazia, a causa está em outro lugar).
github-resolution
A fase de execução: transformar o que a auditoria aprovou em código mergeado. As regras:
- Só executa ticket aprovado, um por vez, com teste de regressão escrito antes da correção. “Slop is a defect”: sem abstração especulativa, sem TODO, sem refactor drive-by, sem teste enfraquecido.
- Se eu resolvi mais de três tickets na sessão, roda o post-audit do intervalo inteiro antes do push, sem exceção.
- Ticket fecha quando o fix está mergeado com CI verde naquele SHA exato, nunca fica pendurado esperando release.
- Toda issue não resolvida fica registrada com o motivo. Comprimir pra um número é proibido.
pr-bump
O fast path pros bumps de dependência do Dependabot. A regra que mais economiza meu tempo: batch, nunca serialize. Em vez de mergear PR por PR, um bundle update consolidado até a última versão compatível, um único passe de CI pro conjunto, fix forward no que quebrar.
Mas tem um supply-chain floor:
- Toda dependência tem que resolver no registry público (rubygems, npm, pypi) com nome, versão e checksum esperados.
- Fonte git, path, nome typosquat-adjacente, hook novo de install: para tudo e vai pra auditoria completa.
bundler-audit passa numa gem trojanizada bem formada. É exatamente o caso que o floor cobre.
release
Corta versão só quando eu peço. As regras de ferro:
- Versão sai da classificação do changelog: fix vai em patch, aditivo em minor, breaking em major. Número que conflita com a classificação me obriga a confirmar, bump silencioso é proibido.
- Gate de CI verde no SHA exato da tag. Nunca tag em CI pendente ou pulado.
- Tag anotada, changelog atualizado.
- Nunca reescrever tag publicada. Nunca cortar release que ninguém pediu.
Os números, porque números não discutem
Contando agora, no dia em que escrevo este artigo, só em três projetos (ai-memory, ai-usagebar e ai-jail):
- ai-memory: 430 PRs mergeados, 260 issues fechadas
- ai-usagebar: 137 PRs mergeados, 34 issues fechadas
- ai-jail: 42 PRs mergeados, 81 issues fechadas
Somando: 609 PRs mergeados e 375 issues fechadas, mais de mil itens. Quase a totalidade disso foi tratada por essas skills, comigo supervisionando e decidindo. Uma pessoa sozinha, sem time, mantendo três projetos ativos nesse volume. É esse o multiplicador.
E elas não nasceram prontas
Abre o histórico de commits do my-skills e você vê skill sendo lapidada na marra. Em julho começa o repo com as auditorias básicas. No fim de julho: “harden audit skills and add security audit”. Em agosto: “consolidate agent skills from all harnesses into this repo” e, dias depois, nasce a github-resolution como fase de execução das auditorias. Em setembro: “fold in release-discipline and audit lessons”.
E ontem mesmo, olha o nível do ajuste fino no pr-bump: “batch all bump PRs into one consolidated verification pass, fix forward on failures” e “require deferred/declined PRs be left in a clean state”. Duas regras que viraram texto de skill. Nenhuma delas saiu de blog post ou de opinião de terceiro: saiu de eu tomar na cara o erro que a regra agora impede.
Cada linha dessas skills é cicatriz.
É assim que se escreve prompt bom: prestando atenção no resultado, decidindo ajustar, ajustando de novo.
Skills são pouco. Conhecimento é muito.
Agora o contraponto, porque eu não quero que você saia daqui achando que a resposta pra tudo é skill. Eu dependo pouco delas. O que carrega meu workflow mesmo é outra coisa.
Cada projeto meu tem seu próprio AGENTS.md, instruções específicas daquele código, e sua memória no ai-memory com decisões e gotchas. E o padrão que eu mais uso no dia a dia nem é skill: é apontar pro exemplo vivo. Quando eu quis AUR automatizado pro clock-tui, eu não escrevi skill de “como fazer pacote AUR”. Eu abri o harness e falei:
make a similar github action to build and publish AUR packages
as we did in ~/Projects/ai-memory
O agente foi lá, leu o workflow que funciona, e reproduz o padrão no novo projeto. Skill pra isso seria pior: AUR muda, GitHub Actions muda, o exemplo fica velho. Exemplo vivo em repo que eu mantenho está sempre atualizado por definição, porque quando ele quebra, eu conserto.
Cada projeto vira base de conhecimento de si mesmo.
E isso generaliza, porque harnesses conseguem consumir qualquer base de texto. Meu PC Linux inteiro está documentado e reinstalável a partir de um repo de config meu, e meu homeserver está todo descrito em runbooks. Esses dois não estão no GitHub: moram num servidor Gitea privado que eu mantenho, porque é o tipo de coisa que eu não quero vazada em público. Quando eu quero mexer em casa, eu falo assim:
add integration to my Plex server as documented in my homelab runbooksNão é skill. É conhecimento organizado, versionado, consultável. Skills são pra procedimento que se repete igual. Conhecimento é pra tudo o mais.
A recomendação que vale mais que qualquer skill
Se você levar uma única prática deste artigo, que seja esta: faça seu agente escrever tudo o que não virou código. Pesquisa que ele fez, decisão que você tomou e por quê, comparação com alternativa rejeitada. Sem isso, esse conhecimento evapora no fim da sessão.
O meu ai-memory, por exemplo, tem uma pasta de docs com pesquisa de competidores que eu mandei fazer antes de cada decisão grande:
- O padrão do wiki do Karpathy, que é a origem intelectual do projeto.
- Survey do landscape 2026, cobrindo Zep/Graphiti, Letta, Mem0 e o Open Knowledge Format do Google.
- Deep-dives de cada concorrente: o Hindsight (o único com paper e funding, que acabou validando minhas apostas de design), o cognee (pipeline de grafo bonito, bug de gateway feio), o agentmemory (do qual eu guardei as ideias e joguei fora o substrato), o basic-memory.
- E a minha favorita, a autópsia do MemPalace: 47 mil stars, viral, e o tracker entupido de corrupção de índice e dado perdido. O conto de fadas ao contrário que me confirmou por que compilar memória é melhor que estocar verbatim.
Dezenas de documentos assim. Cada hora de pesquisa que um agente fez pra mim virou ativo permanente, reutilizável em qualquer projeto novo. Quanto mais você produz e documenta, mais inteligência você acumula.
É juro composto de conhecimento.
Ninguém sabe o que você precisa
E aí fecha o círculo, e voltamos ao ponto do começo: por que eu não recomendo copiar skill de ninguém, nem a minha.
Porque a minha skill de auditoria de PR é moldada em meus projetos, minhas linguagens, meus riscos, meu nível de paranóia com supply chain. Ela reflete o que eu, Fabio, mantendo os repositórios que eu mantenho, na infra que eu tenho, com os objetivos que eu tenho, precisei escrever nela. Seu projeto tem outra stack, outros riscos, outro grau de tolerância. Você pode precisar de checagens que eu não preciso, e o inverso. A experiência é relevante só pra quem viveu as restrições dela. Isso muda de pessoa pra pessoa, e é exatamente por isso que skill de terceiro usada às cegas é aposta.
É a tese do meu vídeo de 2019, Não Terceirize suas Decisões: a lição mais importante da sua vida: ninguém além de você sabe o que você precisa.
Eu não pergunto pra ninguém. Eu pesquiso, eu construo o meu, e as skills são o registro versionado das minhas decisões. A beleza dos LLMs é que eles aceleram esse processo em 10 vezes: a pesquisa que levava uma semana agora leva uma tarde, e o custo de construir sua própria ferramenta despencou.
Skill boa é a sua. A minha está no my-skills pra você ler o raciocínio. Depois fecha a aba e escreve a sua. Eu não desperdiço tempo pedindo a opinião dos outros. Você também não deveria.