Auto-publiquei meu próprio Livro/e-book: Competente o Suficiente
Acabei de publicar meu próprio livro sobre inteligência artificial. Chama Competente o Suficiente, tem o subtítulo “Um ano colocando a inteligência artificial à prova, sem medo e sem propaganda”, e é de graça, em EPUB e PDF, pra ler no celular, no PC ou no Kindle. A página oficial é esta, e o repositório é público.
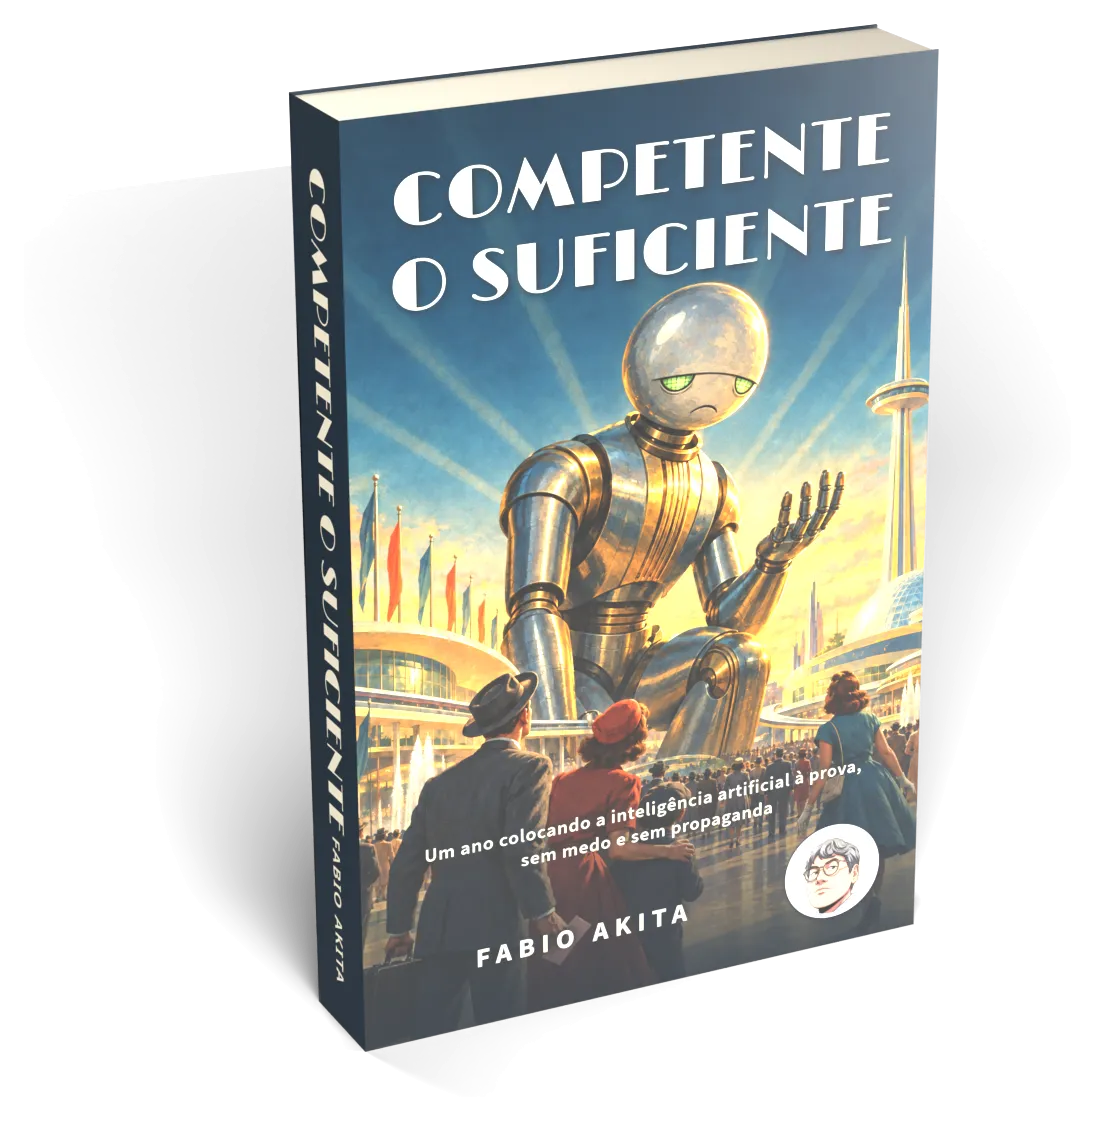
O livro consolida quase tudo que eu escrevi sobre IA aqui no blog de fevereiro a outubro de 2026: todas as experiências, os projetos Frank, os benchmarks, bilhões de tokens gastos e centenas de horas de trabalho ao longo de oito meses, reorganizados num formato mais fácil de ler do que uma pilha de posts datados. Saiu em português e em inglês.
Aviso importante: isso é um preview. O livro ainda está em andamento e vão sair novas versões até eu considerar ele pronto. Se você achar qualquer coisa errada, de erro de digitação a fato, abra uma issue no GitHub. O rastro que eu descrevo abaixo existe justamente pra que a correção chegue no parágrafo certo.
Este texto é sobre o bastidor técnico. Como se transforma 131 posts de blog, escritos ao longo de meses, com opiniões que mudaram no caminho, num livro com começo, meio, fim, apêndice, glossário e bibliografia. E como se faz isso com agentes sem perder o controle do que o livro diz.
O que tem dentro
Cinco partes, cada uma respondendo a uma pergunta que as pessoas vivem me fazendo:
- O que é essa coisa, afinal. Ela é inteligente? A AGI está chegando?
- A maratona. Funciona de verdade, ou é tudo demo?
- Números e propaganda. Qual IA é a melhor? Dá pra acreditar nos anúncios?
- Quem fica com as chaves. É perigoso deixar ela mexer nas minhas coisas?
- E o meu emprego? Ela vai me substituir? O que vem depois?
São 20 capítulos e dois interlúdios, mais prefácio, um “como ler”, um “antes de começar” dizendo o que o livro deixa de explicar e onde aprender, epílogo e posfácio. Depois vêm dez apêndices (a máquina por dentro sem matemática, leituras pra ir mais fundo, como estudar com a IA do lado, três bolhas, linha do tempo, kit mínimo pra usar agente com segurança, ai-memory, como ler um benchmark ou um anúncio, os projetos do ano, e os bastidores pra quem programa), as fontes, os créditos de imagem, um glossário de quase 150 termos e mais de 300 referências em ABNT. A edição impressa passa de 500 páginas em 6 por 9 polegadas; a de tela, uns 475. São mais de 50 figuras, todas com ficha de origem.
O público é diferente do blog. O livro foi escrito pra quem está ansioso ou confuso com IA: o profissional com medo de ser substituído, o pai que leu que a AGI chega em dois anos, o gerente a quem estão vendendo uma “transformação por IA”. A maioria não programa. Isso muda a voz, e eu volto nisso.
O problema: meio milhão de palavras que discordam entre si
Em 12 de outubro publiquei a síntese do ano, que virou o capítulo 20. No dia 13 comecei o livro. Eu tinha 131 textos de 2026 no blog, quase meio milhão de palavras, de benchmark de modelo a carteira de bitcoin.
Reorganizar isso à mão levaria meses. E tem um problema pior que o volume: eu mudei de opinião durante o ano. Refiz o benchmark várias vezes, corrigi custos, troquei de ferramenta, e um post de fevereiro contradiz um de setembro com toda a naturalidade. Um livro que simplesmente colasse os posts em ordem seria um livro que se contradiz.
Então fiz o que o livro inteiro descreve: entreguei o trabalho braçal pra agentes de código, e fiquei com a parte de decidir, montar o processo e conferir. O processo é o assunto deste texto.
Passo 1: um inventário lacrado
A primeira coisa foi um script que lê os 131 posts e grava, pra cada um, o hash SHA-256 do arquivo em português e do arquivo em inglês, mais o commit exato do repositório do blog de onde tudo foi lido. Se uma vírgula muda num post, o hash muda junto. Esse arquivo é gerado por máquina e nunca editado à mão.
Depois, um agente leu cada post e preencheu um formulário fixo, com esquema definido em YAML: a tese em uma ou duas frases, as afirmações que um livro precisaria conferir, quais delas envelhecem rápido, que medo de leitor leigo o texto responde, o que cortar. Cada análise leva o hash do post de onde saiu.
Dos 131 textos, 96 tinham IA como assunto central ou com peso relevante. Os outros só entraram quando ensinavam alguma coisa específica, e cada post sobre IA deixado de fora tem o motivo anotado no arquivo de estrutura. Um script reprova a estrutura se qualquer post de IA estiver sem destino.
Linhagem: quem substitui quem
Pra resolver o problema das contradições, existe um mapa de linhagem. Ele diz qual post substituiu qual, o que ainda dá pra aproveitar do mais velho, e quais correções vindas dos projetos de referência (o repositório do benchmark, o do ai-memory, o do ai-jail, as anotações do meu servidor de casa) se aplicam a cada texto.
A regra pros capítulos é contar o estado mais recente e, quando a mudança ensina alguma coisa, contar a mudança. “Em junho eu achava X; em julho os números diziam Y” é história. Imprimir o número velho como se fosse atual é erro, e o verificador trata como erro.
Passo 2: a estrutura é dado, e gera a configuração
Das análises saiu uma proposta de estrutura: cinco partes, cada uma respondendo a um medo do leitor, vinte capítulos, dois interlúdios. Eu li, mexi e aprovei. Algumas peças entraram a meu pedido, como o “antes de começar” e o apêndice sobre a máquina por dentro.
Essa estrutura vive num único arquivo YAML, e ele é a fonte da verdade. Cada capítulo tem lá o id, o título, a cena de abertura, a pergunta que responde, o arco, a lista de posts de origem e as ideias de figura. A configuração do Quarto, que monta o livro, é gerada a partir desse arquivo por script. Ninguém edita a configuração na mão.
Isso importa porque mudança estrutural é onde livro quebra. No meio do caminho eu mudei o corte: os textos de janeiro saíram, e a história ficou entre fevereiro e outubro. Dez posts sumiram da base.
Três capítulos precisaram de cena nova, uma dúzia de unidades precisou de reparo pequeno, e o estrago difícil de ver estava em outro lugar: uma frase num capítulo intocado dizendo “os cinco revisores do capítulo 5”, a linha do tempo, o apêndice de projetos, rótulos de gráfico, cada tradução. Por isso existe um script de impacto que, antes de qualquer edição, lista cada parágrafo, figura, referência e tradução que depende de um post.
Passo 3: um capítulo piloto vira contrato
Antes de escalar, um capítulo piloto. Escolhi o capítulo 5, sobre os primeiros dez por cento de um projeto, e ele serviu pra calibrar a voz e descobrir as dúvidas que um agente teria no meio do caminho. Cada dúvida resolvida virou uma regra escrita.
Essas regras foram pra um documento de contrato que todo agente lê antes de escrever, junto com três coisas:
- o guia de voz do livro, que herda as regras do blog (o meu WRITER.md, o humanizer e a minha checklist de acabamento) e só adiciona o que muda quando o texto sai de um post datado e vai pra um livro que um leigo segura na mão;
- um arquivo de continuidade, dizendo qual capítulo explica cada conceito e como cada personagem se chama, pra ninguém explicar “janela de contexto” cinco vezes;
- a estrutura inteira, pra cada agente saber o que os outros capítulos cobrem.
Além das regras de voz que já existiam (capítulo abre numa cena com data, lugar e algo em jogo, nunca numa definição; fecha num gancho pro próximo, nunca em “neste capítulo vimos”), algumas das regras que saíram do piloto, pra dar o gosto:
- quando o resumo do capítulo e o post discordam num detalhe, vale o post;
- o capítulo que é dono de um conceito explica direito; se o termo aparece antes na ordem de leitura, ganha meia frase de glosa e um ponteiro, nunca uma segunda explicação;
- fato verificado na internet ganha citação mesmo que o post original não tivesse link;
- nome de modelo e produto na grafia do fornecedor, mesmo quando o blog abreviou.
É o arquivo de instruções de projeto que eu descrevo no capítulo sobre como falar com a máquina, na escala de um livro. Quem já fez um AGENTS.md pra uma base de código reconhece tudo.
Passo 4: rascunhos em paralelo, contradições esperadas
Com o contrato pronto, os capítulos foram rascunhados em paralelo, um agente por capítulo, em duas levas: partes I e II primeiro, depois III a V, pra que os capítulos de trás pudessem construir em cima dos da frente. Cada agente recebia o brief do seu capítulo, as análises, os posts completos, a linhagem e os arquivos dos projetos de referência que precisasse.
Agentes trabalhando ao mesmo tempo se contradizem, e isso aconteceu. Um capítulo dizia que o FrankMD teve uns 130 commits em três dias; outro, que teve 212 em 19 dias. Os dois números vinham dos posts e estavam certos, só que eram janelas diferentes. Um registro de integração juntou esses conflitos, e a regra virou explicitar a janela em cada capítulo.
Depois dos rascunhos vem a passada de integração, com outro conjunto de agentes, cada um dono de um grupo de capítulos e proibido de tocar nos outros. O trabalho deles: aplicar o registro de conflitos, cortar conceito explicado duas vezes, conferir que cada callback bate com o que o outro capítulo de fato diz, garantir que o último parágrafo de um capítulo leva pro primeiro do seguinte, e refazer a conferência de fatos assumindo que o rascunho está errado.
Pra ler as emendas, o build gera um arquivo de “costuras”: o parágrafo final de cada unidade ao lado do parágrafo inicial da próxima. É a leitura mais rápida que existe pra achar onde o livro deixa de parecer um livro só.
Passo 5: uma marca invisível por parágrafo
Esta é a parte que eu acho mais útil do projeto inteiro. Cada parágrafo do livro, no arquivo de origem, carrega um comentário dizendo de onde veio:
<!-- src: 2026/09/28/llms-sao-boas-em-reproduzir-o-que-existe-e-coisas-novas -->
Todo LLM foi treinado só no que é público...

<!-- src: original -->
Texto novo, escrito pro livro.

<!-- src: ref:ai-jail/README.md -->
Fato conferido no projeto de referência.
A marca some na hora de montar o livro, por um filtro Lua do Pandoc, então o leitor nunca vê. Ela serve pra manutenção. Eu edito post depois de publicado o tempo todo, e o livro precisa acompanhar.
O comando rake drift refaz o inventário, compara os hashes, e lista os capítulos que dependem de um post que mudou, com o diff do post desde o commit em que o livro o leu pela última vez. A marca leva direto aos parágrafos que saíram daquele post, e só eles precisam de revisão. Resolvido, um script grava o novo hash e o commit.
Exemplo real, de hoje. Removi do post sobre engenharia reversa um parágrafo sobre um vídeo do Linus Tech Tips. O drift apontou o capítulo 19 e um apêndice; o diff mostrou que aquele trecho nunca tinha sido usado no livro; dois comandos depois, os dois estavam carimbados com o hash novo. Sem a marca, eu teria que reler dois capítulos pra descobrir que não precisava mudar nada.
A bibliografia faz o mesmo papel pras fontes externas: cada referência anota qual post a citou. E as imagens têm cada uma a sua ficha de origem.
Passo 6: o que a conferência pegou
Cada número, data e nome foi conferido contra três oráculos: os posts, os projetos de referência e fontes primárias na internet, com o mesmo prompt de checagem adversarial que eu uso nos artigos do blog. A lista completa está no posfácio do livro, e boa parte das correções é do meu próprio blog:
- no review de março do mini-PC com Strix Halo, eu tinha separado 96 GB de memória pra GPU; em abril baixei pra 64, e posts posteriores ainda diziam 96. O livro usa 64 pra tudo depois de abril;
- um defeito na contagem de uma das ferramentas do benchmark subestimou de 40 a 90 vezes o custo das execuções feitas nela antes de agosto. O livro não cita nenhum desses custos;
- no texto de junho sobre o Claude Fable 5, escrevi que ele custava dez vezes mais que o Opus 4.8 por execução. Refazendo as contas em julho, com os tokens lidos do cache incluídos, o Fable custava quase o dobro. O post ainda diz dez vezes; o livro conta o número errado e a correção;
- num texto de março, escrevi que a Anthropic tinha comprado o Bun no fim de 2024. O anúncio é de dezembro de 2025;
- um resumo de capítulo, escrito por agente, dizia que a trava de assinatura do Claude Code caiu em menos de um dia depois do vazamento. O anúncio saiu umas 30 horas depois, e o livro diz “no dia seguinte”.
Os rascunhos saíram rápido. A confiança no texto veio da conferência. E a fonte vence o resumo, inclusive quando o resumo vem da máquina.
Passo 7: capítulo com erro não passa
Por cima de tudo roda um verificador automático, o equivalente da integração contínua. São scripts em Ruby, só biblioteca padrão, encadeados num Rakefile, mais o que eles chamam por fora: o verificador de gráfico é Python porque vive dentro do matplotlib, a auditoria de página usa o poppler, e o epubcheck precisa de Java:
- um linter de capítulo reprova travessão, frase proibida pelo guia de voz, URL solta no meio da prosa, chave de citação desconhecida, parágrafo sem marca de origem, e avisa de parágrafo longo demais;
- um doctor confere que toda referência cruzada, citação, termo de glossário e figura existe, que a proveniência bate com o inventário, que nenhum post anterior ao corte vazou, que as traduções estão em dia, e faz uma heurística de callback: uma frase que aponta pra outro capítulo usando nomes que aquele capítulo já não contém;
- uma auditoria de página abre o PDF pronto e procura bloco partido entre páginas, título órfão no pé da página, página quase vazia, imagem grande demais, linha estourando a margem;
- um verificador de gráfico procura rótulo que vazou da caixa;
- o epubcheck valida o EPUB 3;
- um relatório de estilo pra copidesque: trecho repetido entre capítulos (consequência inevitável de posts que repetem a mesma tese por ângulos diferentes), frase recorrente, palavra usada demais, variante de termo, comparativo mal formado em português.
E os scripts têm teste. Uma suíte de quase 170 testes monta um livro de mentira num diretório temporário, com cinco posts falsos num repositório git falso, e confere que cada ferramenta pega o problema que deveria pegar. Quando um bug é corrigido, entra o teste que teria pegado ele, com um comentário dizendo qual regressão protege. Roda no CI antes de cada build.
A pipeline de montagem
A toolchain é Quarto, que embute Pandoc e Typst, fixada em versão dentro do repositório. Sem LaTeX. Um único rake build produz, da mesma árvore de arquivos Markdown:
| Saída | Pra quê |
|---|---|
| EPUB 3 | Kindle, Kobo, Apple Books, qualquer leitor |
| PDF de tela | ler no computador ou tablet, com capa |
| PDF de impressão | 6 por 9 polegadas, versos em branco, capítulo abrindo na direita |
| HTML | edição web |
| DOCX | pra editor que quer Word |
Português e inglês são perfis do Quarto, gerados do mesmo arquivo de estrutura. Citações saem de um YAML em formato CSL compartilhado pelas duas edições, com um estilo ABNT ajustado pra português. O glossário é um filtro Lua: cada termo vem marcado no fonte onde aparece, e o filtro liga a marca à entrada, expande a sigla na primeira vez e gera a página.
O Typst resolveu uma coisa que eu achava que ia me custar semanas: PDF com cara de livro tipografado, hifenização em português, ligaduras, sem a dor de TeX. A auditoria de página depois do build pega o que o motor deixou passar, e um rake fit recompila apertando capítulos que terminam numa página quase vazia.
As figuras
Toda figura é código ou tem ficha. Gráficos e diagramas de caixas e setas são scripts de matplotlib, 43 deles, cada um com a indicação do capítulo de onde vieram os dados, e com os rótulos em português e em inglês dentro do próprio script: o mesmo gráfico sai nas duas línguas. O caminho pra diagramas em D2 existe no repositório, e nenhuma figura do livro precisou dele.
As ilustrações conceituais foram geradas por IA, com o modelo, o pedido e a data de cada uma gravados na ficha de crédito, e o livro declara isso. A regra que eu me impus: nenhuma imagem de pessoa real gerada por IA. Pessoas reais só aparecem em fotos com licença livre, com o crédito na legenda.
A capa é o robô retrofuturista de rosto cansado, ajoelhado numa Feira Mundial dos anos 1950, estudando a própria mão enquanto a multidão assiste. O pedido ao modelo descrevia a cena pra segurar três medos de uma vez: o fim da humanidade, perder o emprego, a máquina ficando consciente. A ficha da capa guarda o prompt inteiro. O rosto é o do Marvin, o personagem da minha newsletter, e um adesivo com a minha cara fica ao lado do nome.
As manhas de transformar post em livro
Transformar blog em livro é uma lista de conversões mecânicas, e cada uma tem pegadinha:
- Link vira citação. Cada link externo virou uma entrada de bibliografia, e a frase precisa ficar de pé sem o link. Link pra outro post meu virou referência cruzada pro capítulo que agora cobre aquilo, ou sumiu. Nunca uma URL na prosa.
- “Hoje”, “ontem”, “semana passada”, “atualização:” viraram data absoluta. O livro vai ser lido em 2028 também.
- Versão de modelo, preço, nota de benchmark ficaram como fotografia datada (“em setembro de 2026, o melhor…”), e quando um post posterior substituiu o número, o livro conta a mudança em vez de imprimir o número velho.
- Dump de código, passo de instalação, print de terminal foram cortados. No máximo um trecho de 3 a 8 linhas quando o código é o ponto; o passo a passo foi pra apêndice.
- Título de post, que é feito pra busca (“Vibe Code: fiz X em dois dias”), virou título literário curto, com o assunto no subtítulo.
- Repetição entre posts, a mesma tese por muitos ângulos, é dita uma vez, no lugar certo, e os capítulos seguintes constroem em cima.
- Chamada pra ação, “assine”, “comente”, cortadas.
- A ponta afiada mira na propaganda, nunca no leitor. O post “Você é um idiota se acredita…” virou um capítulo sobre como os anúncios funcionam. O leitor que acreditou no anúncio é a pessoa que o livro quer ajudar.
- Todo termo técnico é explicado uma vez, na primeira aparição no livro, e vai pro glossário.
E a mais importante de todas: o livro lê como história em primeira pessoa, com o ano como espinha dorsal. A informação chega quando a narrativa precisa dela, em vez de seguir ordem de enciclopédia. Isso é o oposto de como um blog é escrito, e foi a regra que mais trabalho deu pros agentes seguirem.
A edição em inglês
A edição em inglês, Competent Enough, só começou depois que eu aprovei a em português. Cada unidade traduzida grava o hash do arquivo em português de onde saiu, e onde o livro segue um post meu que já tinha versão em inglês no blog, a tradução usa a minha própria redação em inglês em vez de traduzir de novo.
O drift também funciona por língua: se eu mudo um parágrafo em português, ele aponta a unidade em inglês que ficou velha, e só os parágrafos marcados são retraduzidos. Os gráficos com texto são gerados de novo em inglês a partir dos mesmos scripts, e a capa em inglês é composta por script em cima da mesma arte.
Lançar é empurrar uma tag
Lançamento é uma entrada no CHANGELOG e um git push de uma tag vX.Y.Z. Um workflow do GitHub Actions roda os testes, monta as duas edições em todos os formatos, valida o EPUB, roda a auditoria e publica a release com os arquivos. Ele apaga todas as releases menos as duas mais novas, e mantém as tags. É assim que a página oficial sempre aponta pra versão atual.
O repositório é público, e isso trouxe uma pegadinha própria: as anotações do meu servidor de casa são fonte de alguns fatos, e são privadas. Os marcadores de origem citam esses arquivos por apelido, o mapa de apelidos fica fora do git, e um hook de pré-push bloqueia qualquer arquivo ou mensagem de commit que contenha nome de repositório privado, host ou IP.
O copidesque: o que a máquina de checagem deixa passar
Lint, doctor, auditoria de página e testes pegam problema estrutural. Eles deixam passar o que um livro escrito por muitos agentes, cada um vendo poucos capítulos, sempre sofre: a mesma frase ou anedota reaproveitada em três capítulos, tom que deriva, terminologia inconsistente, concordância escorregando. Pra isso existe um procedimento de copidesque, que roda uma vez por versão, em três passos do mais barato pro mais caro.
Passo 1, mecânico e quase de graça: o relatório de estilo que eu citei acima. Sequências de sete palavras ou mais que aparecem em mais de uma unidade, ou seja, frase reaproveitada e anedota recontada; frases feitas de quatro a seis palavras usadas em muitos capítulos, que são bonitas como callback e viram tique quando se repetem; palavra usada muito mais num capítulo do que no resto; variante de termo (“e-mail” e “email”, “Open AI” e “OpenAI”); e uma heurística de concordância em português. O relatório é uma lista de trabalho, e nada muda sozinho.
Passo 2, a leitura corrida: um agente só de leitura por parte do livro, cada um lendo as suas unidades em ordem, do começo ao fim, com uma folha de estilo compartilhada (nomes, grafias, termos, frases recorrentes vindas do passo 1). Cada um produz um relatório ranqueado, sem editar nada: erro de digitação e gramática primeiro, depois inconsistência com a folha de estilo, repetição que o leitor notaria, trecho em que um leigo tropeçaria, e ritmo só nos piores casos. Um script valida os relatórios, confere que cada trecho citado existe mesmo na unidade, numera os itens e resume.
Daí vem a triagem, feita por mim com um agente editor, e a aplicação pontual de cada item aprovado, com as mesmas regras da passada de integração. Modelo mais barato faz a revisão; trecho difícil vai pro modelo forte. Orçamento aproximado: dois a três milhões de tokens por língua.
A regra mais importante desse passo é “fato se confere, não se pergunta”. Qualquer item que dependa de um número, data, nome ou comportamento de ferramenta é resolvido pelo editor contra a fonte da verdade antes de chegar em mim: primeiro o post apontado pela marca de origem do parágrafo, recalculando totais; depois o código ou os dados por trás da afirmação, nos meus repositórios; depois registro público.
Quando duas fontes discordam, a tarefa é descobrir por quê. “653 commits em 8 projetos” contra “692 em 4” eram dois recortes do mesmo trabalho, um deles sem o repositório privado da newsletter, e o texto passou a dizer o escopo em vez de escolher um número. Quando o post do blog está errado, o livro imprime o certo e o erro vai pra uma lista de errata do blog, pra eu corrigir na fonte.
Só chega em mim o que fonte nenhuma resolve: fato não publicado, intenção (“isso é ironia?”), preferência de corte ou de título, e contradição entre duas afirmações minhas sem registro pra desempatar. Cada pergunta vem com o que foi conferido e o que foi encontrado.
Passo 3, a minha leitura. A última e a mais valiosa. As notas entram no mesmo ciclo de aplicar, conferir e propagar pra edição em inglês.
A primeira rodada desse copidesque é o que separa o preview 2 do preview 3. Entre o que ela pegou: contagem de commits agora diz o escopo, um “mais de mil” que na soma era 984, o exemplo de votação do Frank Investigator que não batia com o código (figura redesenhada), as citações do David Sacks e do Pirate Wires no capítulo 14 conferidas contra os originais e corrigidas, a foto do Sam Altman trocada por uma de 2025. E na edição em inglês, uma leitura própria depois da ressincronização: decalque de português reescrito, termos do glossário usados do mesmo jeito, pontuação americana de citação do começo ao fim.
Leitores de mentira, feedback de verdade
Copidesque confere o texto. Ele deixa passar a pergunta que importa num livro pra leigo: a pessoa pra quem eu escrevi consegue ler isso até o fim, entende, e sai convencida? Pra responder, a passada seguinte foi uma revisão por leitores simulados.
O prefácio do livro tem uma seção “Pra quem eu escrevi”. Dela saíram cinco personas, cada uma com nome, idade, profissão e o medo que a trouxe ao livro:
- Marina, 38, contadora em Belo Horizonte, leu que o emprego dela “acaba em dois anos”, lê no celular à noite e quer saber o que fazer na segunda-feira;
- Roberto, 52, dono de loja de ferragens, o filho de 15 anos viu um vídeo sobre superinteligência e perguntou se era verdade; desconfia de hype, de “especialista” e de autor que se exibe;
- Carla, 44, gerente de operações numa empresa de logística, a diretoria contratou consultoria vendendo “transformação por IA”; quer uma decisão que ela possa tomar;
- Lucas, 24, desenvolvedor júnior há um ano, com medo de ter escolhido a carreira errada;
- Helena, 61, professora de história aposentada, sem medo nenhum, veio pelas histórias e perde a paciência com lista e manual.
Um agente por persona, só de leitura, modelo mais barato, lê o livro inteiro em ordem como aquela pessoa leria. A instrução é explícita: você é leitor, editor fica de fora; erro de vírgula já foi tratado, reporte só o que muda a experiência de leitura. Cada um devolve uma nota de 1 a 5 por capítulo, um comentário na voz da persona (“finalmente entendi por que o chatbot concorda comigo”, “me perdeu nas tabelas de benchmark”), no máximo 35 anotações classificadas em confuso, chato, reescrever ou lógica, e candidatos a corte. Custa uns 350 mil tokens por persona por leitura completa.
Um editor consolida: a matriz de notas por capítulo e persona e o padrão por trás dela, o que os leitores adoraram (pra proteger em qualquer edição), os itens de lógica, conferidos contra o texto e os posts antes de entrar na lista e corrigidos independentemente de voto, e os itens de clareza ranqueados por quantas personas levantaram. Nota de gosto de uma persona só é descartada. Daí eu decido, e o padrão recorrente vira regra numerada num documento de regras editoriais, com a origem e como é fiscalizado.
A primeira leitura disse o que eu desconfiava e deu a medida: histórias e ferramentas práticas funcionam pra todo mundo; o miolo cheio de medição, os capítulos 11 a 13, perde quem não programa, com nota média entre 2,2 e 2,4. “Afiado quando conta o que aconteceu com ele, me perde quando conta o que mediu”, resumiu a Helena, por todos os cinco.
E os cinco pegaram as mesmas falhas de argumento. A conclusão do capítulo 20 ia além da evidência: dizia “os números dizem que ela não vai ficar mais inteligente” apoiada num benchmark de programação que o próprio capítulo chama de saturado. O capítulo 9 argumentava de um jeito que nunca perde: toda falha do agente era culpa do pedido. Quatro dos cinco foram mandados pro capítulo errado pelo “como ler”.
Isso virou as primeiras regras:
- toda afirmação com o escopo do que foi medido;
- nenhum argumento que não possa perder;
- opinião marcada como opinião;
- o lado contrário na forma mais forte antes de rebater;
- o livro obedece às próprias lições.
Uma rodada só é pouco, porque edição conserta o problema velho e cria o novo. Na segunda rodada, uma frase de desculpa colocada ao lado de uma contradição (“eu sei que isso parece bater de frente…”) fez os cinco leitores notarem a contradição que antes três tinham deixado passar. Virou regra: conserta o desenho, e a desculpa fica fora. Então o processo é em rodadas: ler, editar, ler de novo com as mesmas personas e leitura nova, proibidas de abrir os relatórios anteriores pra evitar ancoragem, e um script compara as rodadas.
| rodada 1 | rodada 2 | rodada 3 | |
|---|---|---|---|
| nota média do livro | 3,32 | 3,38 | 3,41 |
| anotações de lógica | 73 | 53 | 51 |
A nota média é ruidosa (um capítulo intocado oscila 0,6 entre leituras), então o critério de parada é outro: os problemas apontados deixaram de voltar e nada novo chega a três leitores. Na terceira rodada a curva achatou e a revisão parou ali, com uma lista de pendências pra minha própria leitura. O que mudou no caminho: uns 8 mil palavras de caderno de laboratório saíram dos capítulos pra um apêndice novo, “Para quem programa: os bastidores”, cada parágrafo levando a marca de origem junto; a lista de leituras virou apêndice; a seção sobre o Genesys PI foi estacionada, guardada fora do livro enquanto a verificação está pendente; o capítulo 19 ganhou o título que o argumento dele sustenta; cada capítulo abre orientando o leitor antes do primeiro jargão; e o epílogo ganhou uma lista do que fazer nesta semana, por tipo de leitor. Custo das três rodadas: uns 5 milhões de tokens de leitura mais uns 3 milhões de edição e ressincronização do inglês.
O narrador ganhou passado
Com o argumento no lugar, faltava substância na primeira pessoa. O narrador do livro era o Akita de 2026, e eu tenho trinta anos de história que explicam por que eu penso o que penso: o estouro da bolha pontocom visto de dentro, cinco anos integrando SAP em empresa grande, os avisos sobre a bolha de contratação que eu dei em vídeo em 2019, 2020 e 2022, o “Não terceirize suas decisões”. Tudo isso está nas transcrições dos 149 episódios do Akitando, publicadas aqui no blog entre 2018 e 2023.
O processo foi o mesmo do resto do livro, em miniatura. Agentes de extração leram 23 episódios na íntegra, com um formulário: fatos biográficos com a citação literal e o que os verificaria, fatos sobre o mundo, posições recorrentes nas minhas palavras, e ganchos, ou seja, o lugar exato do livro onde uma ou duas frases dessa história sustentam uma afirmação de 2026. Daí saiu um perfil do narrador, que eu confirmei linha a linha, e um plano com uns 30 toques, a maioria de uma a três frases.
Antes de qualquer toque, mais de 140 afirmações tiradas dos episódios passaram pela checagem. Ela corrigiu o livro e corrigiu a mim: a bolha de contratação começou por volta de 2010, com o juro perto de zero, e o meu post de fevereiro dizia 2014; a pontocom estourou entre 2000 e 2002; as demissões de 2022 foram umas 165 mil. E achou erro em episódio antigo que o livro nem usa, que foi pra uma lista de errata do blog.
Os toques entraram onde a experiência vira evidência: a semana de 2001 em que a minha pontocom fechou e um mentor me chamou pra uma consultoria SAP; os anos de SAP por trás da afirmação de que o modelo é cego pras regras privadas de uma empresa; os avisos datados da bolha ao lado do erro admitido, porque em 2022 eu esperava uma segunda perna de queda em 2023 que a onda de IA cancelou. Dois apêndices novos saíram daí: “Três bolhas”, com os números verificados da pontocom, da bolha de juro zero e da onda de IA, e “Como estudar com a IA do lado”, a partir do episódio mais assistido do canal.
Esses episódios são fonte de fundo, e o drift passou a vigiá-los como vigia os posts de 2026. Depois veio uma checagem reduzida com as mesmas cinco personas, só nos capítulos tocados, com três perguntas a mais: a história do narrador deixa o argumento mais convincente, e onde? Alguma passagem parece exibição ou “eu avisei”? Alguma coisa sobre o narrador se contradiz?
Os cinco disseram sim pra credibilidade, com uma condição: a história convence quando é evidência que o leitor consegue checar, o aviso com data ao lado do erro admitido, e convence menos quando vira currículo, o que bate de frente com o próprio livro, que diz “currículo não é argumento”. Virou a regra 21: a história do narrador entra como evidência, e credencial fica de fora.
Três ou quatro leitores marcaram as mesmas linhas como exibição, e elas saíram: “Os avisos têm data”, “mais de trinta repositórios públicos”, “o mais visto do meu canal”. As linhas de autodepreciação e os erros admitidos, todos contaram a favor. E a checagem achou contradições que eu mesmo não tinha visto: o prefácio dizia “fim dos anos 90” e o capítulo 18 dizia 1996; um capítulo falava em “oito meses” e outro em “um ano de uso diário”, e foram consertadas uma a uma.
O que continua sendo meu
O repositório registra o primeiro commit e o rascunho de todos os capítulos no mesmo dia, 13 de outubro. São os primeiros dez por cento, os que impressionam e quase não dizem nada sobre o resto. Os outros noventa por cento são leitura, corte e correção, e essa parte é minha. Nenhum capítulo entra sem eu ler e aprovar, e o que eu mando refazer volta pro mesmo processo.
Qualquer um dos bons modelos de outubro de 2026 teria escrito rascunhos parecidos, porque modelo virou commodity. O que fez o processo funcionar foi o que está em volta dele: o inventário, o contrato escrito, o verificador automático, as fontes como oráculo, o rastro por parágrafo. É a mesma engenharia de software velha que eu defendo em cada capítulo, aplicada a texto.
Os agentes foram competentes o suficiente pra escrever o rascunho. Decidir o que ele dizia continuou sendo trabalho meu.
E, mais uma vez: fazer um livro com IA não é um prompt de “escreva um livro pra mim” e pronto. Eu tive que inventar o processo inteiro e pilotar o agente pra criar cada peça dele: os scripts, os testes, a consolidação dos posts, a estratégia narrativa, os objetivos, o que fica e o que sai, o copidesque, a checagem de fatos, o lançamento automatizado. Você precisa saber exatamente o que quer, e aí a IA ajuda muito. Quem não sabe o que um processo de publicação de livro envolve não vai fazer um livro de verdade, e mostrar isso era um dos objetivos que eu tinha ao criar este exemplo.
Baixe, leia, e me diga onde errei
As duas edições, em três formatos cada, direto do GitHub, sem cadastro. A versão atual é a 1.0.0-preview.5, de 14 de outubro, com tudo que este texto descreve:
| Edição | EPUB (Kindle, Kobo, Apple Books) | PDF pra tela | PDF pra impressão (6 × 9 pol.) |
|---|---|---|---|
| Competente o Suficiente (PT-BR) | EPUB | ||
| Competent Enough (EN) | EPUB |
A versão mais recente, sempre, fica na página do livro e nas releases do GitHub.
É preview. Vai ter erro, e o processo acima existe pra que ele seja corrigido no lugar certo. Achou um, abra uma issue.